Een prijsoorlog blokkeert de uitweg
Normaal kom je uit zo'n situatie door de echte kostprijs door te rekenen. Maar de prijzen gaan net de andere kant op, en dat heeft een duidelijke oorzaak.
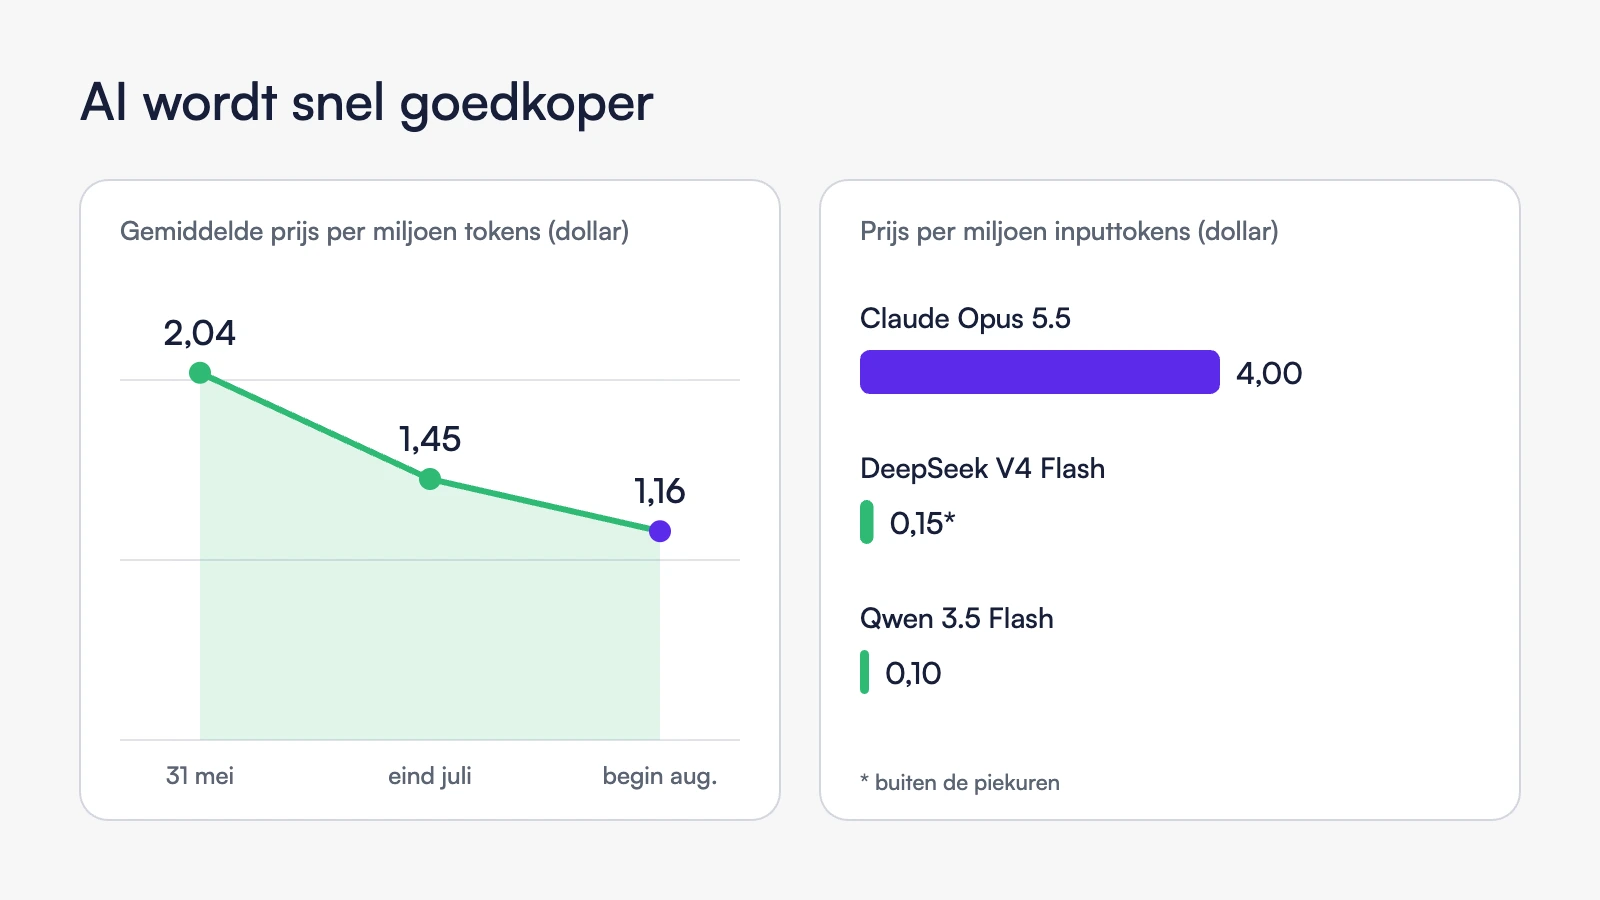
Chinese modellen hebben de achterstand grotendeels ingehaald en kosten slechts een fractie. DeepSeek V4 Flash kost buiten de piekuren 0,15 dollar per miljoen inputtokens. Qwen 3.5 Flash van Alibaba kost 0,10 dollar. Ter vergelijking: Opus 5.5 kost na de prijsdaling nog altijd 4 dollar per miljoen inputtokens. In een vergelijking die Capacity in augustus aanhaalde, kostte dezelfde taak 544 dollar op Zhipu's GLM en 4.811 dollar op Claude. Dat is bijna negen keer zoveel. Volgens de prijsindex van Silicon Data, geanalyseerd door Jefferies, zakte de gemiddelde prijs per miljoen tokens tussen eind mei en begin augustus van 2,04 naar 1,16 dollar.
De westerse labs reageren met prijsdalingen. In augustus zakte GPT-5.6 Luna met 80% en kwam Opus 5 op de markt aan ongeveer de helft van de prijs van zijn voorganger. Eind september volgde de volgende ronde. OpenAI zegt er uitdrukkelijk bij dat de nieuwe prijzen permanent zijn. Sanchit Vir Gogia van Greyhound Research noemt het "a land grab for the default route through which enterprises buy intelligence": een strijd om de standaardroute waarlangs bedrijven AI inkopen. Gartner stelt dat modellen een commodity worden.
Wie marktaandeel koopt met verlies, rekent op een later moment waarop hij de prijs kan zetten. Dat moment komt door consolidatie, door investeerders die geduld verliezen of door een beursgang die rendement moet opleveren. Hoe dat precies loopt, weet niemand. Dat de prijzen van vandaag niet de prijzen van over drie jaar zijn, staat wel vast.